你的照片、APP、系统文件——所有数据最终都以电荷的形式保存在 NAND 闪存的浮栅晶体管中。这篇文章从最小的存储单元讲起,逐层拆解 NAND 的六层嵌套结构,搞清楚为什么”不能直接覆盖写入”这件事,是 GC、写放大、越用越慢等一切现象的物理根源。
最小存储单元:浮栅晶体管
NAND 闪存的基本存储单元是浮栅晶体管(Floating Gate Transistor)。可以把它理解成一个特殊的电控开关。
结构差异
普通 MOS 管有一个栅极,加电压控制电流通断。浮栅晶体管在栅极里面多塞了一个被绝缘层完全包裹的导电”口袋”——这就是浮栅(Floating Gate)。
工作原理
关键就两步:
- 写入(Program):加高压,把电子强行注入浮栅。电子进去之后,阈值电压升高。这个状态代表逻辑 “0”。
- 擦除(Erase):加反向高压,把电子从浮栅里硬拽出来。阈值电压降回去。这个状态代表逻辑 “1”。
为什么断电不丢数据
浮栅四周全是高质量的氧化物绝缘层。电子一旦注入,几乎不可能自己跑出来——断不断电都一样。这就是 NAND 实现非易失性存储的物理基础。
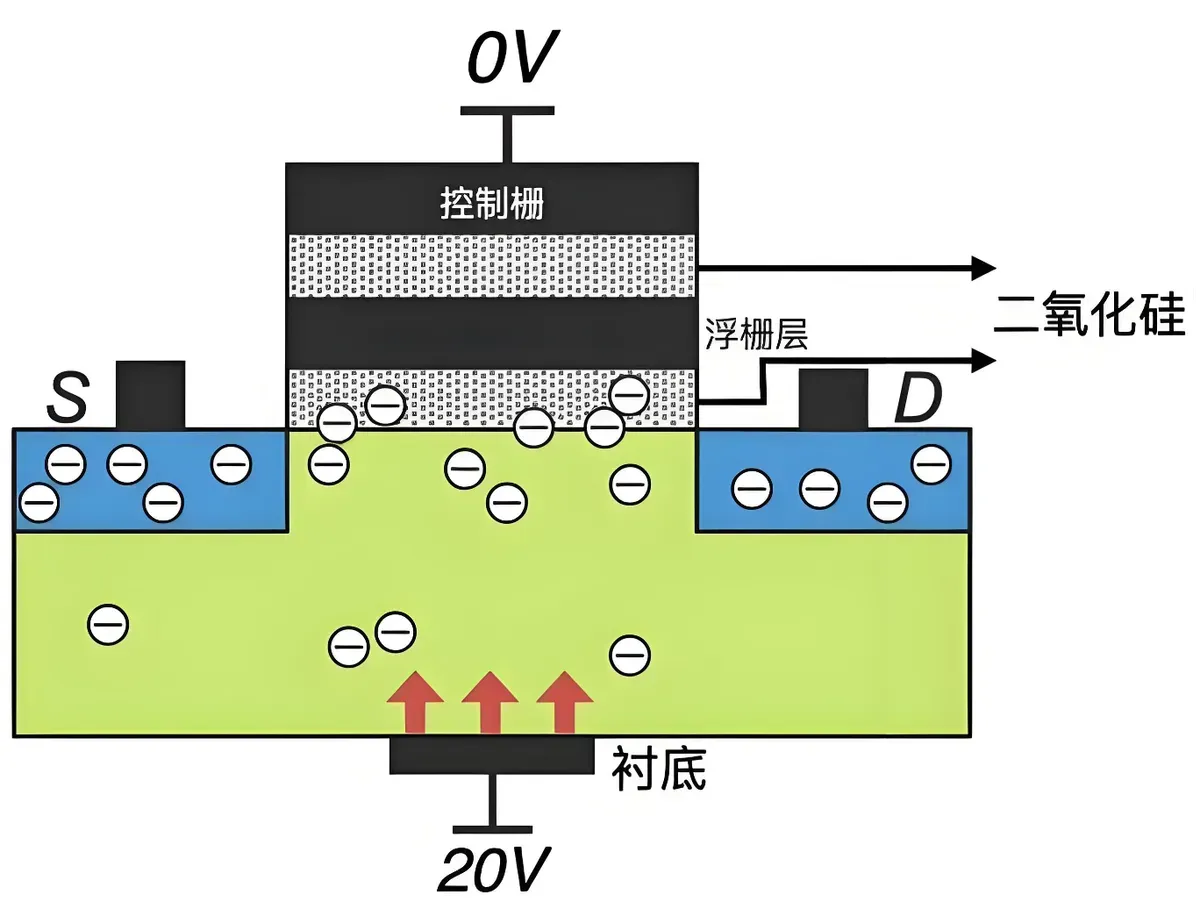
📌 浮栅晶体管是 NAND 一切特性的起点:它决定了写入需要高压、擦除需要整块操作、以及擦除次数有限的物理约束。
六层嵌套结构:从 Cell 到 Wafer
NAND 闪存采用严格的层级组织,从小到大共六层:
| 层级 | 定位 | 关键特性 |
|---|---|---|
| Cell(单元) | 最小存储单元 | 存放 1-4 bit,SLC/MLC/TLC/QLC 的区分 |
| Page(页) | 读写最小单位 | 2KB / 4KB / 16KB,一次至少读写一个页 |
| Block(块) | 擦除最小单位 | 包含数百~数千个 Page,只能整块擦除 |
| Plane(平面) | Block 的集合 | 独立并行操作单元,提升并发性能 |
| Die(晶粒) | 独立芯片单元 | 多个 Plane 组成,可堆叠封装 |
| Wafer(晶圆) | 顶层制造单元 | 一片晶圆切割出数百颗 Die |
📌 记住这个不对称性——读写按页,擦除按块。后面所有的问题,全是从这句话衍生出来的。
为什么读/写按页,擦除偏要按块?
这是 NAND 最核心的”怪癖”,需要从物理层面理解。
读和写——页级操作
通过 Wordline 选中一页内的所有 Cell,一次性读出或写入整页数据。速度很快:
- 读延迟大约 50 微秒
- 写延迟大约 500 微秒
擦除——块级操作
擦除需要加高压,这个高压是加在整个 Block 的衬底上的。物理上没有办法只对一个 Page 施压——要么全擦,要么全不动。速度也很慢:
- 擦除延迟大约 2-5 毫秒,比写慢 10 倍以上
这就像你在纸上写满了字。你可以逐行修改(读/写按页),但要把纸清空重新用?只能整张纸一起处理(擦除按块)。没有”只擦一行”的橡皮。
关键限制:不能直接覆盖写入
有了前面的基础,来看 NAND 最反直觉的设计约束。
你的直觉 vs 物理现实
你以为修改文件是这样的:找到旧数据的位置 → 原地写入新数据。逻辑上完全合理,但 NAND 做不到。
为什么?因为那个 Page 里已经有电荷了(代表旧数据)。你要往里写新东西,得先把旧电荷清掉——也就是擦除。而擦除只能按块来,你不可能为改一个 Page,把整个 Block 几百个 Page 全擦了。
实际流程
控制器是这样处理的:
- 把新数据写入一个已擦除的空 Page
- 把旧数据所在的 Page 标记为 Invalid(无效)
- 用户看到的文件已更新,但旧 Page 还占着物理空间
- 当空闲 Block 不够用时,触发 GC(垃圾回收) 清理无效页
这个流程的后果
每改一次文件,就多一页”垃圾”。用得越久,垃圾越多。直到空闲 Block 快用完——系统被迫暂停正常服务,去做大扫除。这就是**“越用越慢”的物理根源**。
📌 你从买手机第一天开始写入数据,“越用越慢”的种子就已经种下了。
垃圾回收 GC:NAND 的”清洁工”
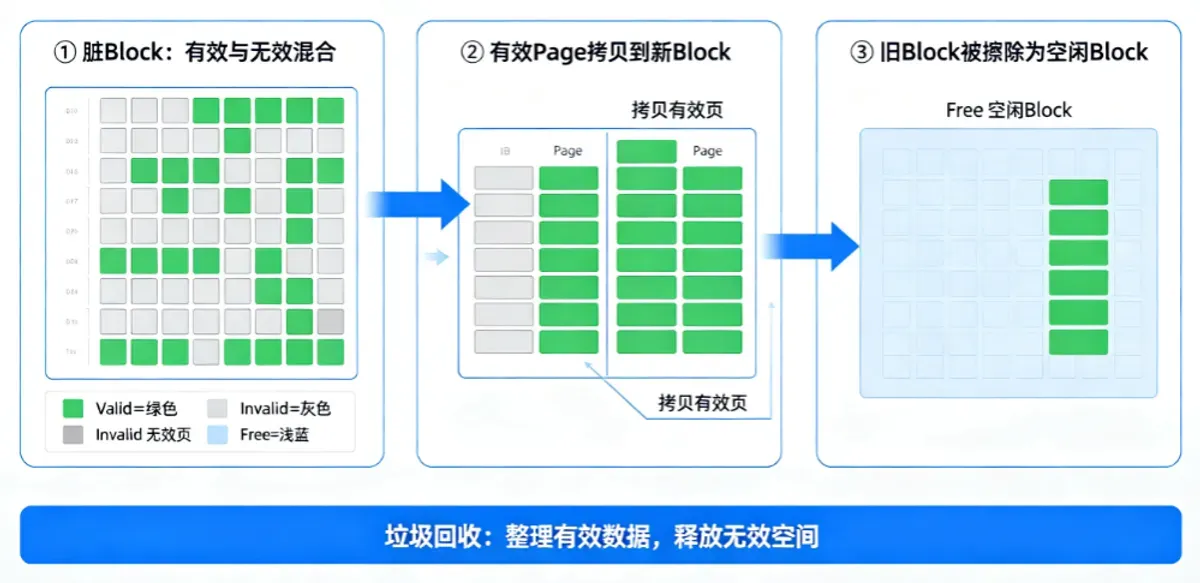
GC(Garbage Collection)说白了就是 NAND 内部的大扫除,分三步走:
第一步:选目标。 挑一个”最脏”的 Block——无效页最多的那个。
第二步:搬数据。 把这个脏 Block 里还有用的、还活着的 Page,小心翼翼地搬到一个全新的空 Block 里。
第三步:擦除。 旧 Block 整体擦除,恢复为空闲,又可以重新用了。
GC 的代价
第二步”搬有用数据”这件事,是额外产生的写入。本来主机只让你写 1MB,因为 GC 要搬数据,NAND 实际写了 2MB。这多出来的 1MB,就是写放大。而且 GC 搬数据的过程会消耗 P/E Cycle,加速磨损。
写放大 WA
写放大的公式很简单:
WA = NAND 实际写入量 ÷ 主机请求写入量这个值永远大于 1。WA 越大,相同的主机写入量对 NAND 的实际磨损就越大,寿命就越短。
| 场景 | WA 典型值 | 说明 |
|---|---|---|
| 顺序写入大文件 | 1.0 - 1.2× | 接近理想值,GC 几乎不触发 |
| 随机写入小文件 | 1.5 - 3.0× | GC 开销开始明显 |
| 盘满时随机写入 | 3.0 - 10+× | 可用空间越少,GC 越频繁,每次能搬的有效数据越少 |
一个实用建议
不要让手机存储用到 90% 以上。留点空间,就是给 GC 留周转的余地——也是给你自己留流畅体验的余地。一旦盘满了,每次写入都触发大量 GC,WA 飙升,又慢又伤寿命,恶性循环。
P/E Cycle:擦写寿命
每个 Block 都有擦写次数上限,叫 P/E Cycle(Program/Erase Cycle)。
每次擦除都是高压把电子从浮栅里硬拉出来,这个过程会缓慢损伤氧化层。次数多了,氧化层退化,电子关不住了——数据就会出错。
| 类型 | P/E Cycle | 定位 |
|---|---|---|
| SLC | ~100,000 次 | 企业级,最长寿 |
| MLC | ~10,000 次 | 工业级,性价比的黄金平衡点 |
| TLC | ~3,000 次 | 消费级主流,成本最低 |
| QLC | ~1,000 次 | 大容量冷数据归档 |
从 SLC 到 QLC,寿命差了 100 倍。这不是厂商偷工减料,而是物理规律——每个 Cell 存越多 bit,电压状态越多、间隔越小,对氧化层退化的容忍度就越低。
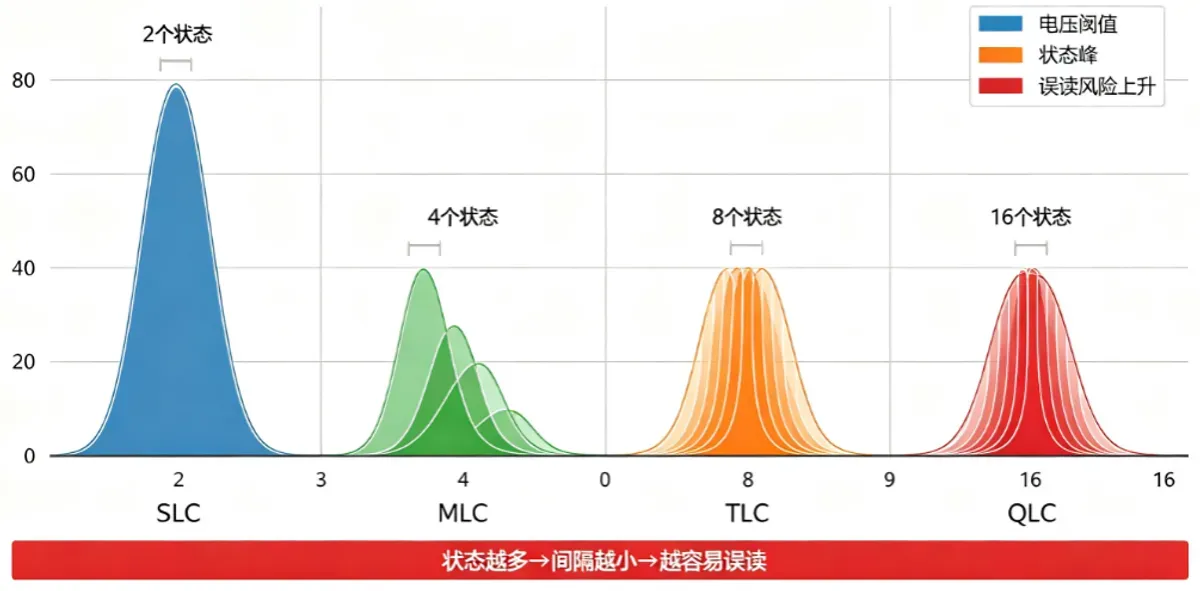
📌 你的旧手机、旧 SSD 用久了丢数据、变慢,不是厂商搞”计划报废”,是氧化层物理退化到了一定程度。
完整因果链
把前文串起来,NAND 闪存的三大核心机制之间存在一条清晰的因果链:
不能直接覆写(物理限制,根因)
    ↓ 每次修改产生无效 Page
无效 Page 堆积,空闲 Block 不足
    ↓ 触发 GC 回收空间
GC 搬移有效数据(额外写入)
    ↓ 实际写入量 > 主机请求量
写放大 WA(副作用)
    ↓ 加速 P/E Cycle 消耗
寿命缩短、越用越慢
把这条链记住了,存储底层的逻辑就通了。
总结
NAND 闪存不是完美的设计——它是物理规律的妥协。
- 优势:高密度、低成本、非易失性
- 代价:不能直接覆写、擦除次数有限、需要 GC
- 关键机制:不能覆写(根因)→ GC(应对)→ 写放大(副作用),一条因果链贯穿始终
理解底层机制,才是真正懂了存储——为什么”越用越慢”、为什么”跑分不等于体验”,答案全在这些物理约束里。
系列导航
| 集数 | 标题 | 内容 |
|---|---|---|
| 第 0 集 | 存储课程总览 | 四大模块介绍 |
| 第 1 集 | 到底什么是存储? | 内存与存储的本质区别 |
| 第 2 集 | 存储类型大盘点 | HDD/SSD/eMMC/UFS 全解析 |
| 第 3 集 | 为什么存储越用越慢? | 碎片、GC、SLC 缓存 |
| 第 4 集 | 三大存储介质 | DRAM/NOR Flash/NAND Flash |
| 第 5 集 | SLC/MLC/TLC/QLC 全解析 | 速度、寿命、成本取舍 |
| 第 6 集 | 存储参数怎么看? | 顺序读写与随机读写 |
| 第 7 集 | UFS 凭什么全面取代 eMMC? | 三大核心优势 |
| 第 8 集 | 一文看懂 UFS 进化史 | 2.0 到 4.1 技术迭代 |
| 第 9 集 | UFS 内部三大核心组成 | 控制器+NAND+DRAM |
| 第 10 集 | NAND 闪存芯片深度解析 | 👈 你在这里 |
下一集:主控芯片——存储的”大脑”有多重要? FTL 地址映射、磨损均衡、坏块管理、CMDQ 调度优化,一次讲透。敬请期待!


